
Când începi să lucrezi cu date și descoperi cât de multe lucruri poate face un instrument precum Power BI, apare foarte repede tentația să automatizezi cât mai mult. Importul, transformarea, clasificarea, corelarea, actualizarea. Dacă ceva poate fi făcut o dată și apoi repetat automat, pare firesc să lași sistemul să facă treaba.
Și, într-o anumită măsură, chiar asta trebuie făcut.
Am descoperit însă că există o diferență importantă între lucrurile care pot fi automatizate și cele care ar trebui automatizate.
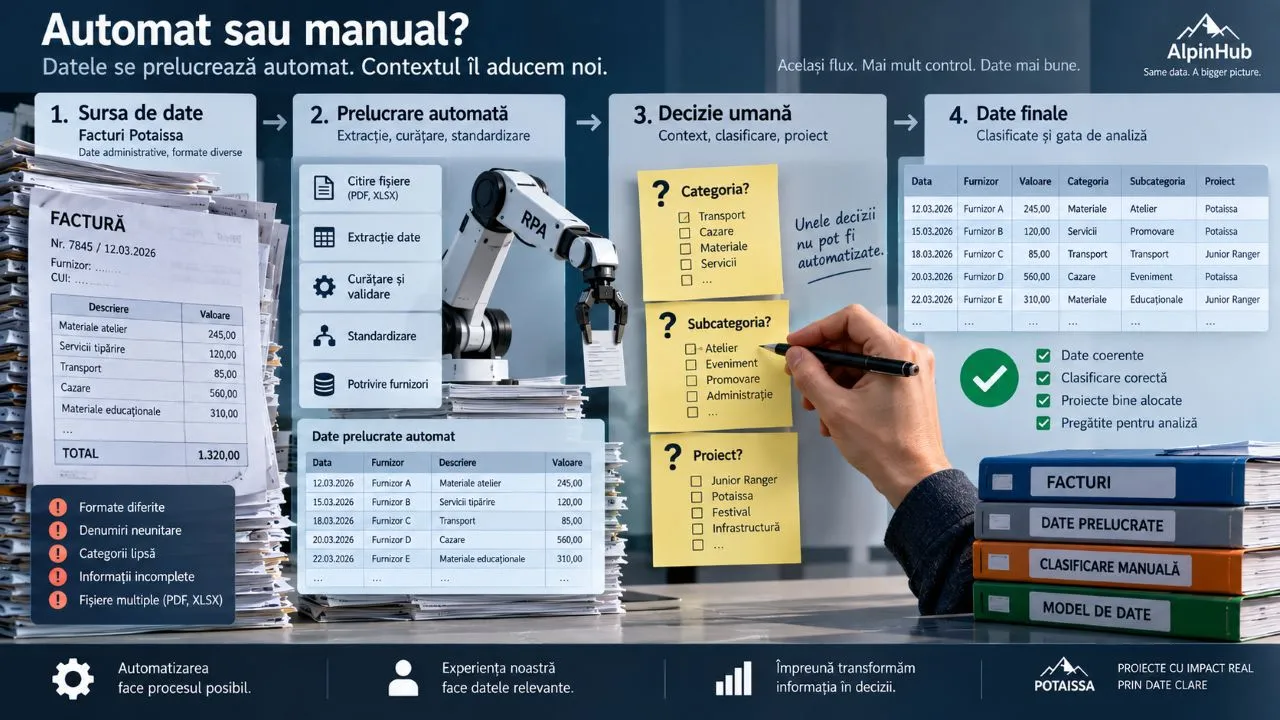
Experiența cu datele Potaissa mi-a arătat cel mai clar această diferență. Aveam un flux de date administrative în care fiecare factură trebuia să ajungă în model cu furnizor, număr de factură, sumă, categorie, subcategorie și proiect. Unele dintre aceste informații erau foarte clare și puteau fi prelucrate fără probleme. Altele nu.
[IMAGINE – Potaissa: fragment anonimizat din tabelul de facturi, cu informațiile venite din sursă separate vizual de câmpurile de clasificare adăugate ulterior, precum Categoria, Subcategoria și Proiectul.]
O factură îmi putea spune foarte bine cine este furnizorul și care este valoarea. Dar nu întotdeauna îmi putea spune, fără echivoc, în ce categorie trebuie încadrată sau cărui proiect îi aparține. Pentru asta era nevoie de context.
Aici am înțeles că automatizarea are o limită foarte interesantă: poate aplica foarte bine o regulă, dar nu inventează contextul pe care nu îl are.
Dacă spun că toate facturile unui anumit furnizor intră într-o categorie precisă, pot construi o regulă. Dacă există însă situații în care același furnizor poate apărea în proiecte diferite sau pentru scopuri diferite, regula simplă începe să devină riscantă.
[IMAGINE – Potaissa: exemplu conceptual cu același furnizor asociat unor categorii sau proiecte diferite, pentru a ilustra de ce aceeași regulă automată nu este întotdeauna suficientă.]
Aș fi putut încerca să automatizez totul. Și probabil că aș fi obținut un sistem care ar fi arătat foarte elegant. Dar eleganța fluxului nu ar fi însemnat neapărat și corectitudinea datelor.
Așa am început să fac o distincție între două tipuri de lucruri. Pe de o parte sunt operațiile repetitive și deterministe: transformarea unui format de dată, calcularea unei valori, standardizarea unui text, eliminarea unor spații inutile, combinarea unor câmpuri sau aplicarea unei reguli care este mereu aceeași. Acolo automatizarea este aproape întotdeauna un câștig.
Pe de altă parte sunt informațiile care depind de sens și context. Acolo trebuie să mă întreb dacă datele conțin suficiente informații pentru ca sistemul să ia singur o decizie corectă.
[IMAGINE – comparație tehnică simplă: în stânga operații deterministe care pot fi automatizate, în dreapta clasificări care necesită context și verificare umană.]
În AlpinHub am întâlnit aceeași problemă, chiar dacă într-o formă diferită.
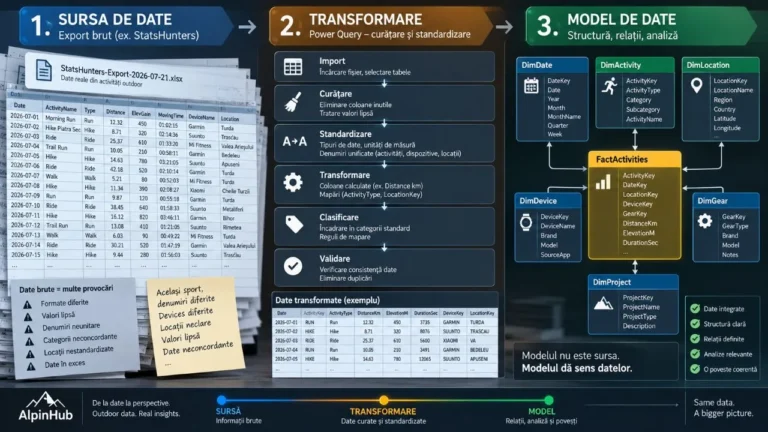
Datele de activitate puteau fi transformate și standardizate în mod repetabil. Puteam converti unități, curăța valori, construi chei, identifica anumite tipuri de activitate sau aplica reguli de mapare. Cu cât repetam mai des aceleași operații, cu atât devenea mai evident că nu are sens să le fac manual.
Dar au existat și situații în care trebuia să verific ce înseamnă efectiv informația. Un dispozitiv putea apărea sub denumiri diferite. O activitate putea necesita o clasificare. O locație putea să nu fie atribuită automat zonei pe care o aveam în minte.
[IMAGINE – AlpinHub: exemplu tehnic și anonimizat de mapare între valoarea venită din sursă și valoarea standardizată în model, cu un caz „Unknown” sau „Unassigned” care necesită verificare.]
Aici mi-am dat seama că automatizarea bună nu înseamnă eliminarea omului din proces. Înseamnă eliminarea muncii repetitive care nu aduce valoare și păstrarea intervenției umane acolo unde ea aduce context.
Este o diferență subtilă, dar importantă.
Dacă fac manual aceeași transformare de o sută de ori, probabil că am o problemă de automatizare. Dacă las sistemul să decidă singur ceva ce nici eu nu pot deduce sigur doar din datele disponibile, probabil că am o problemă de încredere.
Și mai există un lucru: o regulă automată bună trebuie să poată fi explicată.
Dacă un câmp a fost completat automat, vreau să pot spune de ce a primit acea valoare. Nu doar că „a ieșit așa”. Cu cât proiectul crește, cu atât devine mai important să pot urmări logica din spatele transformărilor și clasificărilor.
[IMAGINE – AlpinHub: o mică schemă tehnică „Regulă → Transformare → Rezultat → Verificare”, sugerând că automatizarea trebuie să rămână controlabilă și explicabilă.]
În proiectele mele, această idee a dus și la o separare mai clară între sursă, transformare și informația adăugată ulterior. Nu vreau să pierd ceea ce a venit din sursă doar pentru că am construit o clasificare peste el. Vreau să pot vedea diferența dintre informația originală și decizia pe care am luat-o eu.
În Potaissa, de exemplu, păstrarea acestei logici a fost importantă tocmai pentru că clasificările puteau fi revizuite. Nu trebuia să rescriu istoria doar pentru că o regulă de clasificare s-a schimbat. Iar în AlpinHub, aceeași idee m-a ajutat să construiesc mapări și standardizări fără să confund valoarea originală cu valoarea pe care o folosesc în analiză.
[IMAGINE – Potaissa / AlpinHub: reprezentare simplă a separării dintre „valoare din sursă” și „valoare standardizată/clasificată”, cu posibilitatea de revizuire a regulii fără modificarea datelor originale.]
Cu timpul, am început să privesc automatizarea mai puțin ca pe un obiectiv în sine și mai mult ca pe un instrument.
Nu mă mai întreb doar „pot să automatizez asta?”. Încerc să mă întreb „are sens să automatizez asta?” și, mai ales, „pot avea încredere în rezultatul obținut fără să pierd contextul?”.
Uneori răspunsul este evident. Dacă am de făcut aceeași operație de fiecare dată, nu are rost să o repet manual. Alteori răspunsul este la fel de clar în direcția opusă: dacă informația nu poate fi interpretată corect fără să cunosc contextul, intervenția umană nu este un defect al sistemului.
Este, de fapt, o parte din sistem.
[IMAGINE – imagine tehnică, minimalistă, cu un flux în care automatizarea preia operațiile repetitive, iar anumite puncte de decizie rămân marcate pentru verificare umană.]
Cred că aici am învățat ceva care depășește Power BI. Un sistem bun nu este neapărat cel care face totul singur. Este cel care știe ce poate face singur, ce trebuie verificat și unde este nevoie de o decizie.
Iar când începi să lucrezi serios cu datele, această diferență devine foarte importantă. Pentru că, în cele din urmă, nu vreau doar un proces rapid. Vreau un proces în care să pot avea încredere.
Și de aici apare următoarea întrebare, aproape inevitabil: cum verificăm că ceea ce a făcut sistemul este corect?