
La început, când lucrezi cu un set de date, este tentant să te uiți mai ales la ceea ce poți obține din el: ce poți calcula, ce poți compara, ce grafic poți construi sau cum poți pune informațiile într-un raport. Cu timpul apare însă o întrebare mai importantă: cât de mult pot avea încredere în ceea ce văd?
Întrebarea a apărut firesc pe măsură ce proiectele au început să se adune. Unele date veneau din aplicații și exporturi, altele din fișiere Excel sau CSV, iar structurile nu erau întotdeauna aceleași. Au apărut valori lipsă, înregistrări duplicate, denumiri diferite pentru același lucru, informații care nu puteau fi asociate și situații în care o valoare părea corectă doar pentru că se încadra într-un tabel. Așa am început să privesc mai atent ceea ce intră în model și, mai ales, ceea ce iese din el.
Verificarea nu a apărut ca o etapă separată, stabilită de la început. A devenit necesară atunci când rezultatele au început să fie folosite pentru comparații și interpretări. În AlpinHub, de exemplu, o activitate nu înseamnă doar o distanță și un timp. Există o dată, un tip de activitate, un dispozitiv, o sursă, o localizare, o denumire și alte informații care pot influența felul în care acea activitate ajunge să fie analizată. Dacă una dintre ele este greșită sau lipsește, problema poate să nu fie vizibilă imediat în datele brute, dar poate apărea mai târziu în raport.
De aici a venit nevoia de a verifica datele nu doar la nivel de valoare individuală, ci și la nivelul relațiilor dintre ele. O valoare poate fi corectă în sine și totuși să producă un rezultat greșit atunci când este asociată cu o altă informație.
Datele lipsă
O valoare lipsă este una dintre cele mai simple probleme de observat și, în același timp, una dintre cele mai ușor de interpretat greșit. Dacă lipsește un dispozitiv, o localizare sau o categorie, există tentația de a completa automat informația. Uneori acest lucru este posibil și corect, pentru că există o regulă clară sau o altă sursă care permite completarea. Alteori nu avem suficiente informații pentru a face asta.
Am învățat să fac diferența între o informație care poate fi completată printr-o regulă și una care pur și simplu nu există în sursă. În al doilea caz, este mai corect să păstrez lipsa sau să o marchez decât să inventez o valoare care face tabelul să arate mai bine. Într-un model de date, „Unknown” sau „Neatribuit” poate fi o informație utilă, pentru că ne spune că există ceva ce încă nu știm.
Duplicatele
Duplicatele sunt mai interesante decât par. Două rânduri identice sunt ușor de observat, dar același eveniment poate apărea de mai multe ori cu mici diferențe. În proiectele legate de activități outdoor, problema a dus inclusiv la folosirea unei chei pentru identificarea activității. Nu era suficient să mă uit la nume sau la distanță. Trebuia să existe un mod mai sigur de a identifica înregistrarea și de a verifica dacă ceea ce intră în model reprezintă într-adevăr activități distincte.
Un duplicat introdus în model nu produce neapărat o eroare vizibilă. Poate pur și simplu să mărească un total, să schimbe o medie sau să facă o comparație să pară diferită. Tocmai de aceea verificarea trebuie să existe înainte de interpretare, nu doar după ce raportul este construit.
Denumiri, clasificări și informații neclare
O altă categorie de probleme apare atunci când informația există, dar nu este exprimată într-o formă suficient de clară pentru model. Același dispozitiv poate apărea sub denumiri diferite, o activitate poate avea o categorie care nu corespunde clasificării folosite în raport, iar o localizare poate exista în sursă, dar să nu poată fi asociată cu una dintre categoriile din model.
În AlpinHub au apărut astfel de situații sub forme precum dispozitive necunoscute, locații neatribuite sau valori care necesitau o regulă de mapare. Aici curățarea datelor nu înseamnă doar să fac textul să arate uniform, ci să înțeleg ce reprezintă informația și ce rol va avea mai departe. O modificare care pare corectă la nivel de text poate schimba sensul datelor dacă este făcută fără context.
Verificarea după transformare
O parte importantă a procesului apare după ce datele au fost transformate. Power Query poate să standardizeze coloane, să schimbe tipuri de date, să combine informații sau să elimine probleme evidente, dar faptul că transformarea s-a executat fără eroare nu înseamnă că rezultatul este automat corect.
Trebuie verificat ce s-a întâmplat cu datele după transformare. Numărul de înregistrări mai este același atunci când ar trebui să fie? Valorile importante s-au păstrat? O regulă de filtrare nu a eliminat accidental ceva relevant? O asociere nu a creat duplicate? O coloană calculată are sens în contextul modelului? Am ajuns astfel să verific nu doar dacă Power Query poate face o transformare, ci și dacă transformarea respectivă este potrivită pentru ceea ce vreau să analizez.
Același lucru este valabil și pentru calculele făcute ulterior. O formulă DAX poate fi perfect validă din punct de vedere tehnic și totuși să răspundă la o întrebare formulată greșit. Din acest motiv, verificarea nu se termină atunci când modelul nu mai afișează erori.
Cum se vede calitatea datelor în raport
La un moment dat apare o întrebare firească: dacă știm că există probleme în date, unde le vedem? Nu toate problemele trebuie eliminate înainte ca datele să ajungă în raport. Unele trebuie chiar să fie vizibile acolo, pentru ca rezultatul să poată fi interpretat în contextul potrivit.
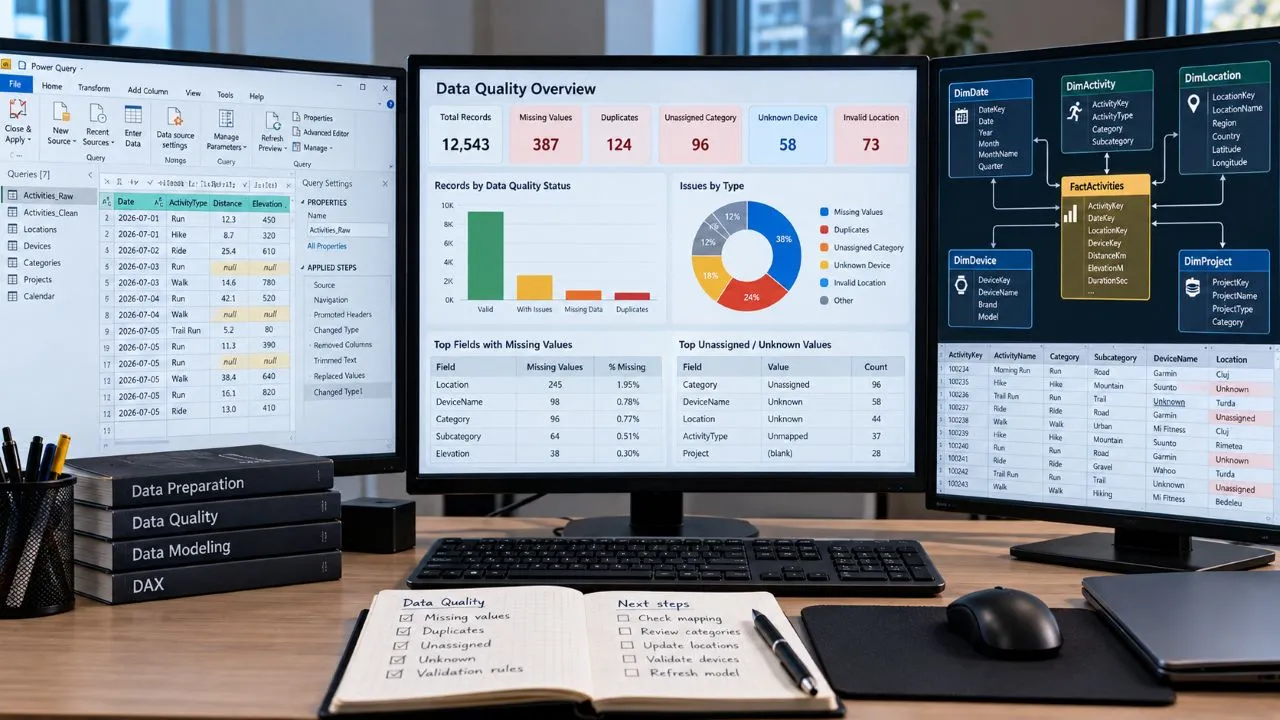
În AlpinHub, partea de Data Quality a ajuns să includă informații despre înregistrări neatribuite, dispozitive necunoscute, valori care trebuiau verificate și alte situații care puteau influența analiza. Cardurile, tabelele de control, filtrele și indicatorii pot face aceste lucruri vizibile fără să încarce inutil raportul. În felul acesta, raportul nu mai este doar locul în care sunt prezentate rezultatele, ci și un loc în care putem vedea cât de sănătoase sunt datele care au produs acele rezultate.
Un raport bun nu ar trebui să ascundă problemele doar pentru că acestea fac rezultatul mai puțin frumos. Uneori un card care arată câte înregistrări sunt incomplete este mai util decât încă un grafic. Este o diferență importantă între a corecta o problemă și a o ascunde, iar felul în care alegem să reflectăm problema în raport poate fi la fel de important ca modul în care am tratat-o în model.
Sursa versus ceea ce obținem
Pe măsură ce transformările se adună, devine important să pot reveni la sursă și să înțeleg de unde a venit o informație. De aceea am început să separ tot mai clar datele de origine de ceea ce construiesc ulterior în model. Sursa trebuie să rămână suficient de aproape de forma inițială pentru a putea verifica informația, în timp ce modelul poate fi organizat pentru analiză.
Această separare ajută și atunci când ceva nu mai pare corect. Pot urmări informația înapoi și pot vedea dacă problema a apărut în sursă, în transformare, în mapare sau în model. Cu cât proiectul crește, cu atât această posibilitate devine mai importantă.
Câtă încredere putem avea în rezultat?
Probabil că aceasta este întrebarea care le leagă pe toate. Nu am nevoie întotdeauna de date perfecte. Am nevoie să știu ce date am, ce probleme există, ce am modificat și ce impact pot avea aceste lucruri asupra rezultatului.
Un model poate funcționa foarte bine chiar dacă are câteva valori lipsă, atâta timp cât acestea sunt cunoscute și tratate corespunzător. În schimb, un model care pare perfect, dar ascunde duplicate sau clasificări greșite, poate produce rezultate în care nu ar trebui să am încredere.
DQ nu înseamnă, așadar, să facem toate datele perfecte. Înseamnă să le înțelegem suficient de bine încât să știm ce putem face cu ele și cât de mult ne putem baza pe ceea ce obținem.
Ce a rămas important
Din toate proiectele prin care am trecut, verificarea datelor a devenit una dintre acele activități care apar aproape peste tot, indiferent dacă vorbim despre activități outdoor, observații iNaturalist, date despre un teritoriu sau informații administrative. Se schimbă sursa, se schimbă structura și se schimbă întrebările, dar problemele se repetă: ceva lipsește, ceva apare de două ori, ceva nu este clasificat, ceva nu se leagă sau ceva trebuie verificat.
Cu timpul, nu mai este nevoie să descoperi fiecare problemă de la zero. Începi să recunoști tiparul. Iar asta mi se pare una dintre cele mai utile părți ale experienței acumulate cu datele: nu faptul că pot construi un raport care arată bine, ci faptul că pot să mă uit la date și să-mi pun mai devreme întrebarea dacă ceea ce urmează să construiesc are o bază suficient de bună.
Pentru că, până la urmă, încrederea într-un raport începe cu încrederea în datele din spatele lui.